

Πώς κάνουμε χρήση του pgvector στην PostgreSQL για AI και Vector Search

Πιστοποιήσεις:
- Πώς κάνουμε χρήση του pgvector στην PostgreSQL για AI και Vector Search - 26 Οκτώβριος 2026
- Πώς ενεργοποιούμε το Native Steaming Replication σε PostgreSQL - 19 Οκτώβριος 2026
- Πώς κάνουμε Partitioning σε υφιστάμενο πίνακα στη PostgreSQL και πώς το συντηρούμε - 12 Οκτώβριος 2026
Οι σύγχρονες εφαρμογές τεχνητής νοημοσύνης και τα Large Language Models βασίζονται σε δεδομένα που ονομάζονται διανύσματα (vectors ή embeddings). Η PostgreSQL, χάρη στην ευελιξία της, μπορεί να μετατραπεί σε μια πλήρη διανυσματική βάση δεδομένων με τη βοήθεια του pgvector.
Σε αυτόν το άρθρο θα δούμε με απλά λόγια τι είναι, πώς εγκαθίσταται στην PostgreSQL σε περιβάλλον RHEL, πώς λειτουργεί στην πράξη και ποια ευρετήρια (indexes) μας συμφέρει να χρησιμοποιήσουμε.
Τι είναι το pgvector;
Το pgvector είναι ένα πρόσθετο (extension) για την PostgreSQL που μας επιτρέπει να αποθηκεύουμε διανύσματα και να κάνουμε αναζητήσεις με βάση το νόημα (semantic search). Αντί να ψάχνουμε απλώς για λέξεις κλειδιά, μπορούμε να βρούμε κείμενα, εικόνες ή προϊόντα που μοιάζουν μεταξύ τους, κάνοντας το ιδανικό για συστήματα τεχνητής νοημοσύνης.
Εγκατάσταση του pgvector στην PostgreSQL 14
Για να το προσθέσουμε στον server μας, το κάνουμε build απευθείας από τον πηγαίο κώδικα με μερικές εύκολες εντολές.
Πρώτα, εγκαθιστούμε τα απαραίτητα εργαλεία
sudo yum install -y git make gcc postgresql14-devel
Στη συνέχεια, κατεβάζουμε τον κώδικα, ορίζουμε πού βρίσκεται το pg_config της έκδοσης 14 και κάνουμε την εγκατάσταση:
cd /tmp
git clone https://github.com/pgvector/pgvector.git
cd pgvector
make PG_CONFIG=/usr/pgsql-14/bin/pg_config
sudo make PG_CONFIG=/usr/pgsql-14/bin/pg_config install
Τέλος, συνδεόμαστε στη βάση δεδομένων και ενεργοποιούμε το extension:
CREATE EXTENSION vector;
Παράδειγμα
Αφού ενεργοποιήσουμε το extention, μπορούμε να φτιάξουμε έναν πίνακα που περιέχει πεδία διανυσμάτων και να δοκιμάσουμε μια αναζήτηση.
Δημιουργούμε έναν πίνακα με 3 διαστάσεις και βάζουμε μερικές εγγραφές:
CREATE TABLE items (
    id SERIAL PRIMARY KEY,
    name TEXT,
    embedding VECTOR(3)
);

INSERT INTO items (name, embedding) VALUES
('Item A', '[1, 2, 3]'),
('Item B', '[1, 1, 1]'),
('Item C', '[4, 5, 6]');
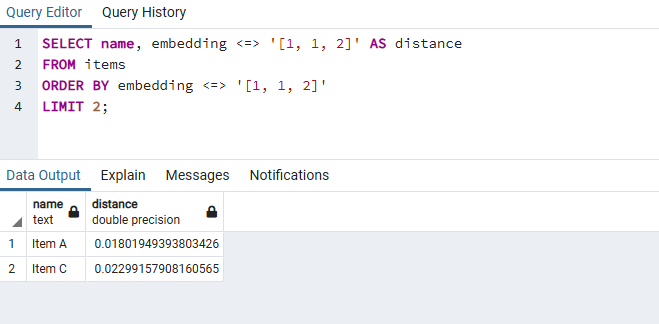
Για να βρούμε ποιο αντικείμενο μοιάζει περισσότερο με ένα συγκεκριμένο διάνυσμα βάσει της απόστασης συνητόνου (Cosine distance), τρέχουμε το εξής query:
SELECT name, embedding <=> '[1, 1, 2]' AS distance
FROM items
ORDER BY embedding <=> '[1, 1, 2]'
LIMIT 2;
Ποια Index να διαλέξουμε: HNSW ή IVFFlat;
Όταν τα δεδομένα μας γίνουν πάρα πολλά (χιλιάδες ή εκατομμύρια), η απλή αναζήτηση αργεί. Τότε δημιουργούμε ειδικά ευρετήρια (indexes) για να πηγαίνουμε πιο γρήγορα. Τότε έχουμε δύο επιλογές:
IVFFlat Index
Ο αλγόριθμος IVFFlat χωρίζει τα διανύσματα σε ομάδες (clusters) ώστε ο server να ψάχνει μόνο στις κοντινές ομάδες. Είναι αρκετά γρήγορος, αλλά θέλει να υπάρχουν ήδη αρκετά δεδομένα στον πίνακα όταν τον φτιάχνουμε, αλλιώς η βάση δεδομένων θα μας βγάλει προειδοποίηση ότι έχει χαμηλή ακρίβεια.
Για να δημιουργήσουμε ένα IVFFlat index, εκτελούμε:
CREATE INDEX items_ivfflat_idx ON items USING ivfflat (embedding vector_cosine_ops) WITH (lists = 100);
HNSW Index
Ο αλγόριθμος HNSW φτιάχνει μια δομή σαν δίκτυο και προσφέρει εξαιρετικά μεγάλη ταχύτητα και κορυφαία ακρίβεια αναζήτησης. Το μόνο αρνητικό είναι ότι καταναλώνει περισσότερη μνήμη RAM, οπότε η επιλογή εξαρτάται από τους πόρους που διαθέτει ο server μας.
Για να δημιουργήσουμε ένα HNSW index, εκτελούμε:
CREATE INDEX items_hnsw_idx ON items USING hnsw (embedding vector_cosine_ops);
