

Τι είναι η TimescaleDB (Tiger Data) και πώς διαχειριζόμαστε Time-Series δεδομένα στη PostgreSQL

Πιστοποιήσεις:
- Τι είναι η TimescaleDB (Tiger Data) και πώς διαχειριζόμαστε Time-Series δεδομένα στη PostgreSQL - 2 Νοέμβριος 2026
- Πώς κάνουμε χρήση του pgvector στην PostgreSQL για AI και Vector Search - 26 Οκτώβριος 2026
- Πώς ενεργοποιούμε το Native Steaming Replication σε PostgreSQL - 19 Οκτώβριος 2026
Στα σύγχρονα περιβάλλοντα βάσεων δεδομένων, όλο και πιο συχνά καλούμαστε να αποθηκεύσουμε και να αναλύσουμε Time-Series δεδομένα. Τέτοια δεδομένα είναι για παράδειγμα οι μετρήσεις από αισθητήρες (IoT), τα metrics παρακολούθησης συστημάτων (CPU, RAM), τα logs εφαρμογών ή οι οικονομικές συναλλαγές, όπου κάθε εγγραφή συνοδεύεται από ένα timestamp.
Όταν αυτά τα δεδομένα φτάσουν σε δισεκατομμύρια εγγραφές, ένας κλασικός πίνακας στη PostgreSQL αρχίζει να αντιμετωπίζει προβλήματα: τα indexes μεγαλώνουν, η ταχύτητα των INSERT και SELECT πέφτει, και η χειροκίνητη διαχείριση των partitions γίνεται μπελάς.
Εδώ έρχεται η TimescaleDB (η οποία πλέον έχει μετονομαστεί σε TigerData, αν και σε επίπεδο πακέτων και εντολών διατηρεί το όνομα timescaledb). Πρόκειται για ένα extension της PostgreSQL που τη μετατρέπει σε μια Time-Series βάση δεδομένων, χωρίς να χάνουμε τίποτα από την PostgreSQL. Τα δύο μεγαλύτερα χαρακτηριστικά της είναι:
Hypertables & Chunks: Αυτόματο partitioning των δεδομένων με βάση τον χρόνο, χωρίς καμία χειροκίνητη παρέμβαση από τον DBA.
Hypercore (Columnar Compression): Μετατροπή των παλαιότερων δεδομένων από γραμμές (Row-store) σε στήλες (Columnstore) και συμπίεσή τους, εξοικονομώντας συχνά πάνω από 90% χώρο στον δίσκο.
Σε αυτό το άρθρο θα δούμε βήμα-βήμα πώς να εγκαταστήσουμε, να ρυθμίσουμε και να χρησιμοποιήσουμε την TimescaleDB σε περιβάλλον PostgreSQL 14 και RHEL Linux 7.
Εγκατάσταση της TimescaleDB
Αρχικά, προσθέτουμε το επίσημο repository της TimescaleDB στο σύστημά μας, στη προκειμένη περίπτωση είναι RHEL 7:
sudo tee /etc/yum.repos.d/timescale_timescaledb.repo <<'EOF'
[timescale_timescaledb]
name=TimescaleDB
baseurl=https://packagecloud.io/timescale/timescaledb/el/7/$basearch
enabled=1
gpgcheck=0
repo_gpgcheck=0
sslverify=1
metadata_expire=300
EOF
Καθαρίζουμε τυχόν παλιότερα repositories και την cache του yum, και προχωράμε στην εγκατάσταση του πακέτου για την PostgreSQL 14:
sudo rm -f /etc/yum.repos.d/timescaledb.repo
sudo yum clean all

sudo yum install -y --nogpgcheck timescaledb-2-postgresql-14
Η TimescaleDB συνοδεύεται από το εργαλείο timescaledb-tune, το οποίο διαβάζει τους πόρους του server μας (CPU, RAM) και ρυθμίζει αυτόματα το αρχείο postgresql.conf για βέλτιστη απόδοση, ενώ προσθέτει και τη βιβλιοθήκη της TimescaleDB στο shared_preload_libraries:
sudo timescaledb-tune --pg-config=/usr/pgsql-14/bin/pg_config
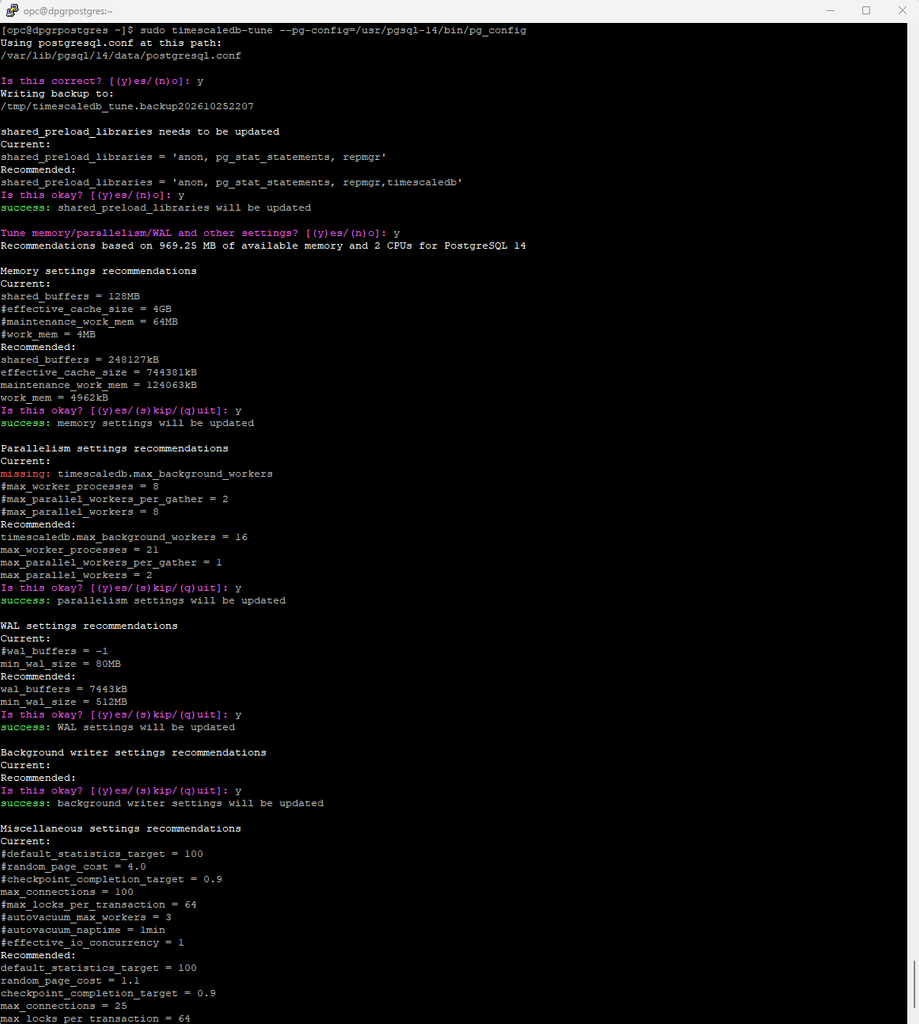
Αφού ολοκληρωθεί η ρύθμιση, επανεκκινούμε την PostgreSQL για να εφαρμοστούν οι αλλαγές:
sudo systemctl restart postgresql-14
Συνδεόμαστε στη PostgreSQL και ενεργοποιούμε το extension της TimescaleDB:
sudo -u postgres psql
CREATE EXTENSION IF NOT EXISTS timescaledb;
Δημιουργία Hypertable και Εισαγωγή Δεδομένων
Το Hypertable είναι το κύριο πλεονέκτημα της TimescaleDB. Για τον χρήστη φαίνεται και λειτουργεί ακριβώς όπως ένας κανονικός πίνακας. Στο παρασκήνιο όμως, η TimescaleDB σπάει αυτόματα τα δεδομένα σε μικρότερα χρονικά partitions που ονομάζονται Chunks.
Αρχικά, δημιουργούμε έναν κλασικό πίνακα PostgreSQL που θα κρατάει μετρήσεις από αισθητήρες:
CREATE TABLE sensor_data (
    time TIMESTAMPTZ NOT NULL,
    sensor_id INT NOT NULL,
    temperature DOUBLE PRECISION,
    cpu_load DOUBLE PRECISION
);
Στη συνέχεια, με μία μόνο εντολή, τον μετατρέπουμε σε Hypertable, ορίζοντας ότι θέλουμε να χωρίζεται αυτόματα σε Chunks ανά 1 ημέρα (INTERVAL '1 day') με βάση τη στήλη time:
SELECT create_hypertable('sensor_data', by_range('time', INTERVAL '1 day'));
Ας εισάγουμε τώρα 100.000 τυχαίες εγγραφές με εύρος τις τελευταίες 10 ημέρες για να δοκιμάσουμε τη λειτουργία του:
INSERT INTO sensor_data (time, sensor_id, temperature, cpu_load)
SELECT
    NOW() - (random() * INTERVAL '10 days'),
    (random() * 50)::INT,
    20.0 + (random() * 15.0),
    random() * 100.0
FROM generate_series(1, 100000);
Χωρίς να χρειαστεί να φτιάξουμε κανένα partition χειροκίνητα, η TimescaleDB είδε τα timestamps των εγγραφών που βάλαμε και δημιούργησε αυτόματα τα αντίστοιχα ημερήσια Chunks. Μπορούμε να τα δούμε εκτελώντας το παρακάτω query:
SELECT chunk_name, range_start, range_end, is_compressed
FROM timescaledb_information.chunks
WHERE hypertable_name = 'sensor_data'
ORDER BY range_start DESC;
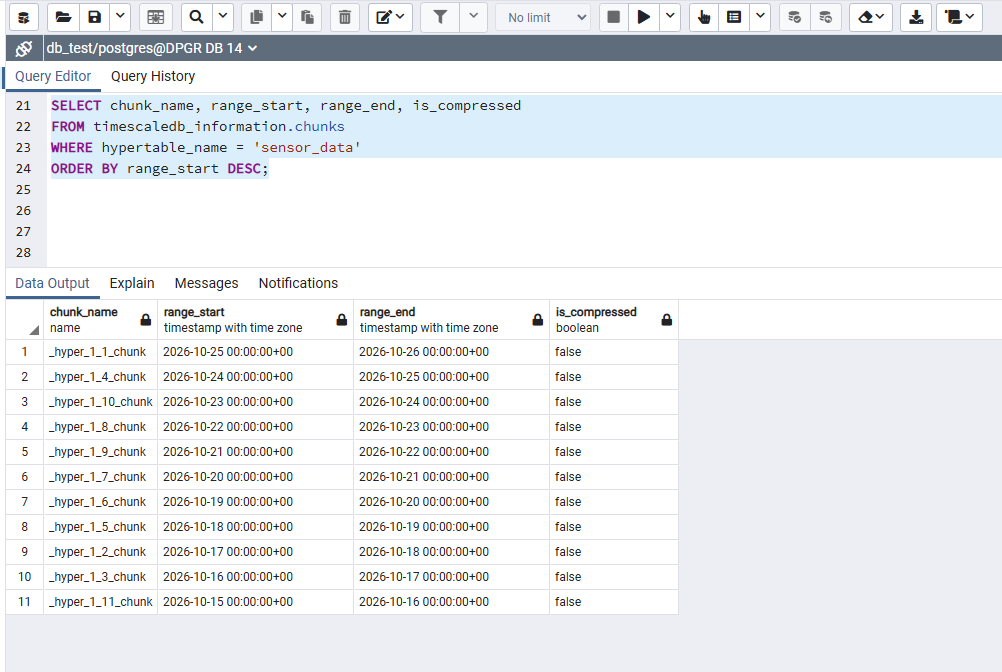
Θα δούμε ότι ο πίνακας μας έχει ήδη χωριστεί σε επιμέρους ημερήσια κομμάτια (chunks), κάνοντας τα ερωτήματα που ψάχνουν συγκεκριμένες ημερομηνίες εξαιρετικά γρήγορα.
Ενεργοποίηση Hypercore (Columnstore / Compression)
Στα δεδομένα Time-Series, τα πρόσφατα δεδομένα δέχονται συνεχώς νέες εγγραφές, αλλά τα παλαιότερα δεδομένα (π.χ. προηγούμενων ημερών ή μηνών) παραμένουν στατικά και χρησιμοποιούνται μόνο για ανάγνωση (reporting/analytics).
Μέσω της αρχιτεκτονικής Hypercore (Columnar Compression), η TimescaleDB μας επιτρέπει να συμπιέσουμε τα παλιά Chunks μετατρέποντάς τα από row-based αποθήκευση σε αποθήκευση στηλών (Columnstore).
Αρχικά, ενεργοποιούμε τη δυνατότητα συμπίεσης / Columnstore πάνω στο Hypertable μας, ορίζοντας πώς θα ομαδοποιούνται (compress_segmentby) και πώς θα ταξινομούνται (compress_orderby) τα δεδομένα μέσα στα συμπιεσμένα chunks:
ALTER TABLE sensor_data SET (
    timescaledb.compress,
    timescaledb.compress_segmentby = 'sensor_id',
    timescaledb.compress_orderby = 'time DESC'
);
Χειροκίνητη Συμπίεση (Manual Compression)
Αν θέλουμε να συμπιέσουμε άμεσα (χειροκίνητα) όλα τα Chunks που είναι παλαιότερα από 5 ημέρες, εκτελούμε:
SELECT compress_chunk(i)
FROM show_chunks('sensor_data', older_than => INTERVAL '5 days') i;
Αυτοματοποιημένη Συμπίεση (Compression Policy)
Στην πράξη, δεν θέλουμε να τρέχουμε τη συμπίεση χειροκίνητα. Μπορούμε να ορίσουμε ένα Compression Policy, ώστε η TimescaleDB να συμπιέζει αυτόματα στο background κάθε Chunk μόλις αυτό ξεπεράσει τις 5 ημέρες ηλικίας:
SELECT add_compression_policy('sensor_data', INTERVAL '5 days');
Αν για οποιονδήποτε λόγο θέλουμε να αφαιρέσουμε το policy αυτοματοποίησης, τρέχουμε:
SELECT remove_compression_policy('sensor_data');
Για να ελέγξουμε τα ενεργά background jobs συμπίεσης:
SELECT * FROM timescaledb_information.jobs WHERE proc_name = 'policy_compression';
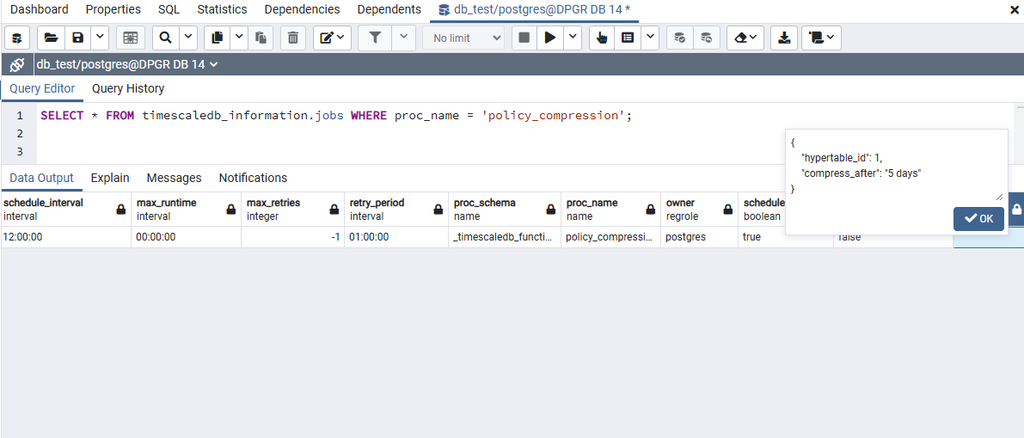
Για να δούμε πόσο χώρο εξοικονομήσαμε πριν και μετά τη συμπίεση, εκτελούμε:
SELECT * FROM hypertable_compression_stats('sensor_data');
Στα αποτελέσματα before_compression_total_bytes vs after_compression_total_bytes, μπορούμε να παρατηρήσουμε την μείωση στο μέγεθος που καταλαμβάνουν τα δεδομένα μας, ενώ συνεχίζουμε να κάνουμε κανονικά SELECT πάνω στον πίνακα sensor_data χωρίς να αλλάξουμε απολύτως τίποτα στον κώδικα της εφαρμογής μας!
